 Bildiğiniz gibi yapay zekâ dünyasında odak artık AI ajanlarına kayıyor. Belli başlı görevleri otonom olarak yerine getirebilen bu yapay zekâlar, yavaş yavaş sohbet botlarından görevi devralıyor. Ancak bu sistemler yaygınlaştıkça, her karar için büyük dil modellerine başvurmaları da daha büyük bir sorun hâline geliyor. Bir sohbet botunun kullanıcıya uzun bir cevap vermesi ya da karmaşık bir problemi çözmesi gerektiğinde büyük bir dil modelinden faydalanmak mantıklı olabilir; fakat bir AI ajanının karar sürecinin aşamasında tekrar tekrar büyük dil modeline danışması pek verimli bir sitem değil. Neticede bu tür durumlarda ihtiyaç duyulan şey yeni bir metin üretmek değil, mevcut seçenekler arasından bir karar vermek. Dolayısıyla son dönemde bu probleme çözüm getirebilecek JEV gibi “System One” modelleri ön plana çıkmayı başladı.
JEV gibi modellerin temel fikri, her karar için büyük bir dil modelinin uzun uzun düşünmesine gerek olmadığı fikrine dayanıyor. Bunun yerine model, önceden belirlenmiş seçenekler arasından doğrudan bir karar verebiliyor. Örneğin bir AI ajanının “hangi aracı kullanmalıyım?” sorusuna cevap vermesi gerekiyorsa, uzun bir metin üretmek yerine mevcut seçenekleri değerlendirip en uygun aracı seçiyor. Böylece hem çıktının yapısı daha öngörülebilir hâle geliyor hem de gereksiz token üretiminin önüne geçilerek karar süreci hızlandırılabiliyor.
Dolayısıyla JEV yapay zekâ dünyasında heyecan uyandırdı. Ancak spot ışıkları altındaki süresi pek uzun olmadı. Çünkü daha şimdiden onu gölgede bırakabilecek bir başka model sahneye çıktı.
CLM, JEV’den 9 Kat Daha Hızlı Çalışıyor
Stanford ve NVIDIA araştırmacıları tarafından geliştirilen Contrastive Language Models (CLM), aynı problemi farklı bir mimariyle çözmeye çalışıyor. CLM, yalnızca seçenekler arasından karar vermek yerine mevcut durum ile olası eylemler arasındaki ilişkiyi öğreniyor. Araştırmacıların testlerinde CLM, özellikle çok sayıda aday eylemin bulunduğu veya aynı eylemlerin tekrar tekrar kullanılabildiği senaryolarda JEV’e kıyasla 9 kata kadar daha düşük gecikme süresi sundu.
Ancak buradaki “9 kat” ifadesinin tüm kullanım senaryoları için geçerli olmadığını belirtmekte fayda var. CLM’nin avantajı özellikle çok sayıda aday eylemin bulunduğu veya aynı eylemlerin farklı durumlarda tekrar tekrar kullanıldığı senaryolarda ortaya çıkıyor. JEV, sınırlı seçenekler arasından hızlı ve yapılandırılmış kararlar vermeye odaklanırken CLM, durum-eylem ilişkisini öğrenerek bu iki tarafı birbirleriyle eşleştirmeye çalışıyor.
CLM Modeli Nasıl Çalışıyor?
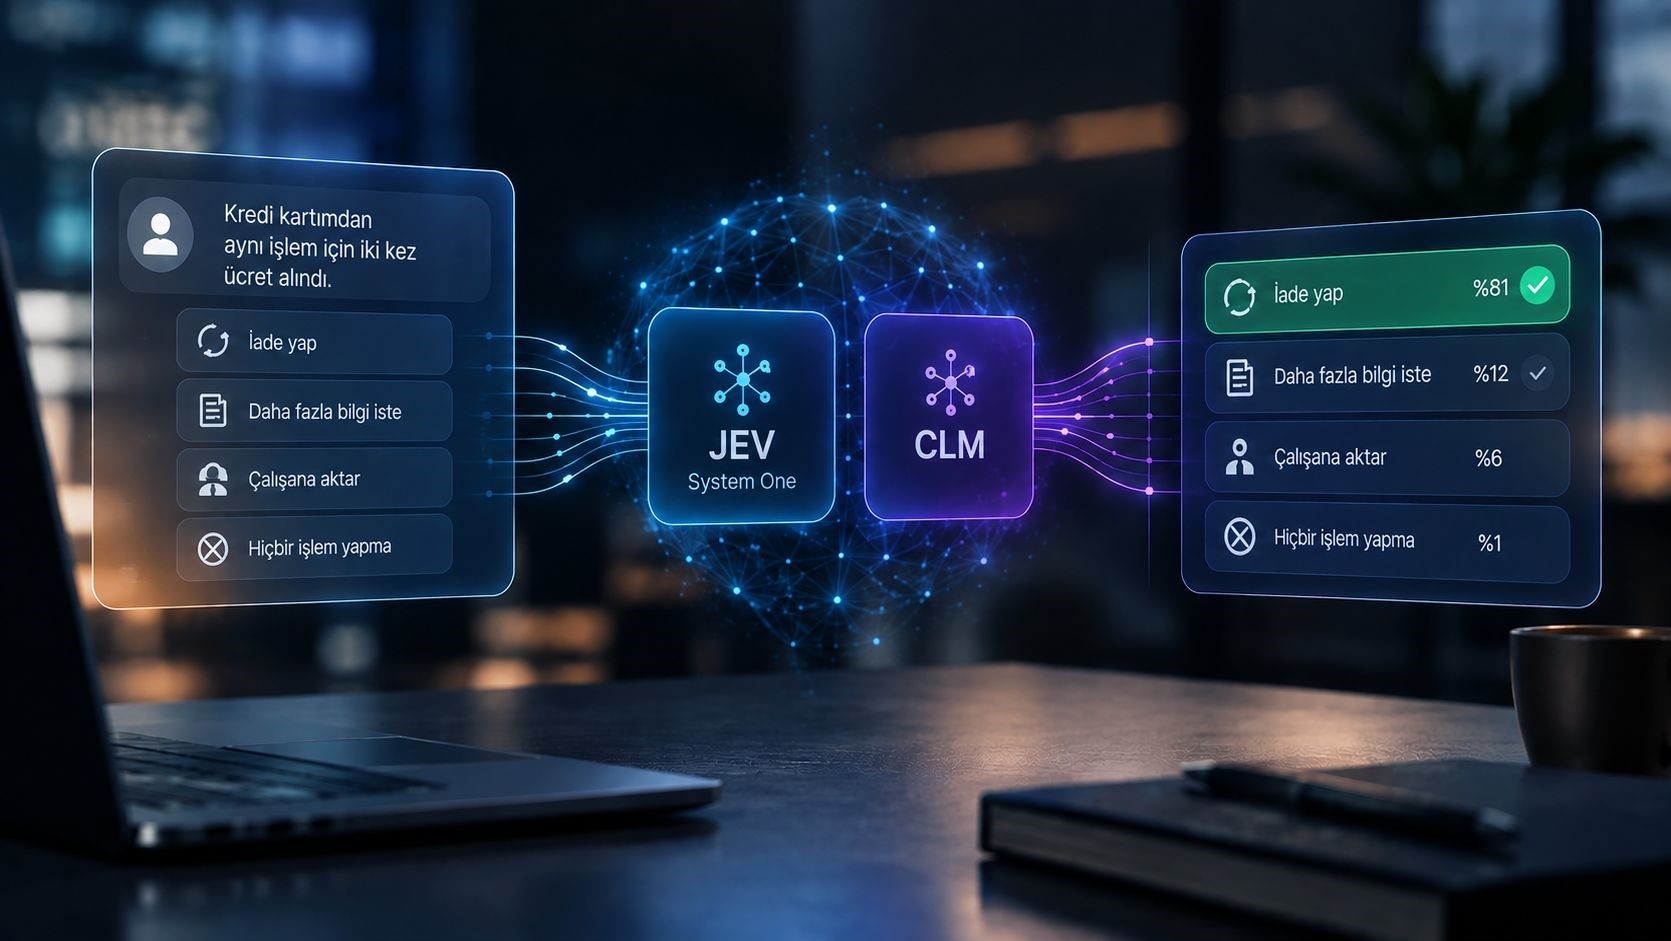
CLM modelinin nasıl işlediğini anlamak için bir AI ajanının nasıl çalıştığını düşünelim. Örneğin bir bankanın müşteri hizmetlerinde kullanılan bir AI ajanı, “Kredi kartımdan aynı işlem için iki kez ücret alındı.” şeklinde bir mesaj aldığında önünde birkaç seçenek oluyor: Müşteriye para iadesi yapmak, müşteriden daha fazla bilgi istemek, konuyu insan bir çalışana aktarmak veya herhangi bir işlem yapmamak. Bugün kullanılan yaklaşımda sistem, bu mesajı büyük bir dil modeline gönderir ve modelden uygun eylemi belirlemesini ister. Model de isteği analiz eder, bir düşünce süreci yürütür ve sonunda “Bu durumda para iadesi seçeneği uygun görünüyor.” şeklinde bir çıktı üretir. Ama aslında sistemin böyle bir cevaba ihtiyacı yok. İhtiyaç duyduğu tek şey “Para İadesi” seçeneğinin seçilmesi. İşte JEV ve CLM gibi yeni nesil karar modelleri tam olarak bu noktada devreye giriyor. Bu yaklaşım, büyük dil modellerinin her problemi metin üreterek çözmeye çalışmak yerine, karar verilmesi gereken durumlarda daha küçük ve özel modeller kullanılabileceği fikrine dayanıyor. JEV, bu tür modeller için “System One” kavramını öne çıkarırken, Stanford ve NVIDIA araştırmacılarının geliştirdiği CLM ise aynı probleme farklı bir mimariyle yaklaşıyor.
CLM’nin temelinde oldukça basit görünen ancak önemli sonuçlar doğuran bir fikir bulunuyor: Mevcut durumu ve olası eylemleri aynı uzayda temsil etmek ve hangilerinin birbirine daha çok uyduğunu ölçmek.
Örneğin sistemin karşısında şu durum olduğunu düşünelim:
“Müşterinin kredi kartından aynı işlem için iki kez ücret alınmış.”
Sistemin kullanabileceği eylemler ise şöyle olsun:
-
REFUND (Para iadesi)
-
ASK_FOR_DETAILS (Daha fazla detay iste)
-
IGNORE (Yok say)
CLM öncelikle mevcut durumu sayısal bir temsile dönüştürüyor. Benzer şekilde bu eylemlerin her biri de birer sayısal temsil hâline getiriliyor. Daha sonra model, mevcut durum ile hangi eylemin birbirine en çok benzediğini hesaplıyor.
Basitleştirilmiş şekilde sistem şöyle çalışıyor:
Mevcut durum → Durum temsili → Eylemlerle karşılaştırma → En uygun eylem
Sonuçta “kredi kartından iki kez ücret alınması” durumu ile Para İadesi eylemi diğer seçeneklere kıyasla daha güçlü bir eşleşme gösteriyorsa model doğrudan bu seçeneği belirliyor. CLM’deki “contrastive” yani karşılaştırmalı yaklaşım da adını buradan alıyor. Model eğitim sırasında doğru durum-eylem çiftlerini birbirine yaklaştırırken, yanlış eşleşmeleri birbirinden uzaklaştırmayı öğreniyor. Böylece model yalnızca “doğru cevap nedir?” sorusuna değil, “Bu durum hangi seçenekle en iyi eşleşiyor?” sorusuna odaklanıyor.
CLM’nin En İlginç Özelliklerinden Biri de Eylemlerin Önbelleğe Alınabilmesi
CLM’yi özellikle AI ajanları açısından ilgi çekici hâle getiren noktalardan biri de durum ve eylem temsillerinin birbirinden bağımsız olarak hesaplanabilmesi. Örneğin bir şirketin AI ajanında 500 farklı araç bulunduğunu düşünelim. Bunların arasında e-posta gönderme, veritabanında arama yapma, destek kaydı oluşturma, sunucuyu yeniden başlatma, ödeme iadesi yapma veya bir güvenlik olayını ilgili ekibe aktarma gibi araçlar olabilir. Geleneksel bir sistemde bu araçların açıklamalarının her yeni istekte modele aktarılması gerekebilir. Böylece modelin karşısına kabaca şu çıkar:
Kullanıcının isteği + 500 araç tanımı + büyük dil modeli → uygun aracı seç
Bu hem bağlamı büyütüyor hem de her karar için yeniden hesaplama yapılmasını gerektiriyor.
CLM ise burada farklı davranabiliyor. Mevcut araçların temsilleri önceden hesaplanıp önbelleğe alınabiliyor. Daha sonra yeni bir kullanıcı isteği geldiğinde yalnızca değişen durumun temsili hesaplanıyor ve daha önce hazırlanmış eylem temsilleriyle karşılaştırılıyor. Örneğin kullanıcı “Üretim ortamındaki ödeme işlemleri HTTP 503 hatası veriyor.” dediğinde CLM, bu yeni durumu mevcut araçlarla karşılaştırarak Splunk’ta arama, sunucuyu yeniden başlatma veya ödeme iadesi gibi seçenekler arasından uygun olanı seçebiliyor. Buradaki avantaj özellikle aynı eylemlerin tekrar tekrar kullanıldığı sistemlerde ortaya çıkıyor. Çünkü eylem temsilleri bir kez hesaplandıktan sonra farklı durumlarda yeniden kullanılabiliyor.
AI Ajanlarının Birden Fazla “Beyni” Olabilir
 Bugün yapay zeka sistemlerinde çok sayıda farklı görev tek bir büyük dil modeline yükleniyor. Model hem planlıyor, hem araç seçiyor, hem kod yazıyor, hem ürettiği sonucu kontrol ediyor hem de gerektiğinde işlemi yeniden başlatmaya karar veriyor. CLM gibi modeller ise bu mimarinin değişebileceğini gösteriyor. Örneğin gelecekte bir AI ajanı şöyle çalışabilir:
Büyük dil modeli: Planlama, akıl yürütme, kod yazma ve karmaşık problemleri çözme
CLM/JEV gibi karar modeli: Araç seçme, sonuçları sıralama, doğrulama, yeniden deneme veya işlemi durdurma
Böyle bir sistemde büyük model yalnızca gerçekten ihtiyaç duyulan noktalarda çalıştırılırken, çok sayıda küçük karar daha hızlı ve daha düşük hesaplama maliyetiyle alınabilir. Bu özellikle yüzlerce farklı araçla çalışan kurumsal yapay zekâ ajanlarında önem kazanabilir. Örneğin bir ajan GitHub, Jira, Slack, ServiceNow, Splunk, veritabanları ve farklı API’lere erişebiliyorsa, her seferinde bütün bu araçların tanımlarını büyük bir dil modelinin bağlamına taşımak yerine CLM benzeri bir model önce en uygun birkaç seçeneği belirleyebilir. Ardından asıl akıl yürütme modeli yalnızca bu seçenekler üzerinde daha kapsamlı bir değerlendirme yapabilir.
Belki de geleceğin ajanlarında tek bir büyük “beyin” yerine, her biri farklı bir görevi üstlenen birkaç farklı model birlikte çalışacak.
Kaynak: bmw 418d